Linear regression là gì (Hồi quy tuyến tính) là một phương pháp phân tích thống kê và học máy có giám sát (Supervised Machine Learning) nền tảng, được sử dụng để mô hình hóa mối quan hệ phụ thuộc tuyến tính giữa một biến kết quả liên tục (Biến phụ thuộc Y) và một hoặc nhiều biến giải thích (Biến độc lập X). Thông qua việc xác lập một đường thẳng hoặc siêu phẳng toán học khớp với tập dữ liệu thực nghiệm, hồi quy tuyến tính giúp các nhà khoa học, chuyên gia tài chính và nhà quản trị đo lường chính xác mức độ tác động nhân quả và dự báo xu hướng biến động trong tương lai.
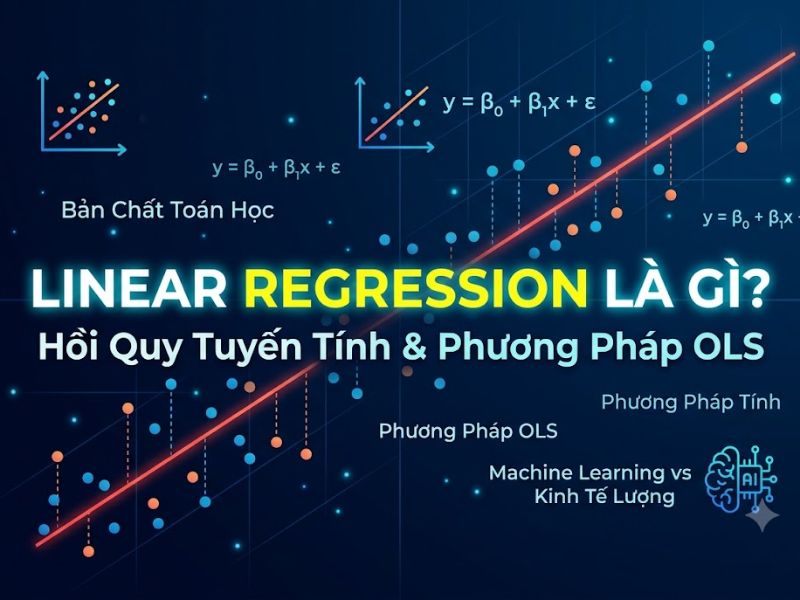
Bản chất toán học và phân loại mô hình Linear Regression
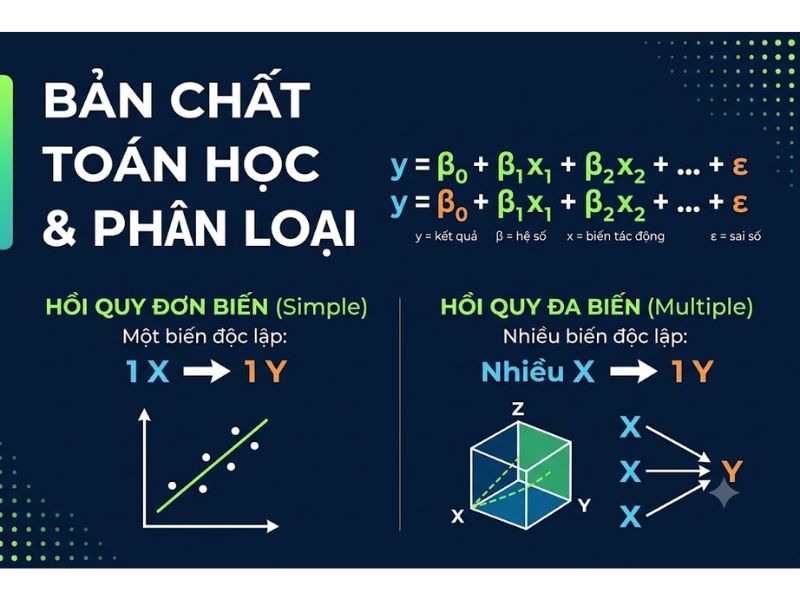
Khái niệm “tuyến tính” (Linear) trong Linear regression là gì mang ý nghĩa cốt cựu là tuyến tính đối với các tham số hồi quy (β), nghĩa là không có hệ số β nào có số mũ lớn hơn 1 hoặc nhân chia với nhau. Dựa trên số lượng biến độc lập tham gia, mô hình được chia thành 2 dạng chính:
1. Hồi quy tuyến tính đơn biến (Simple Linear Regression)
Khảo sát mối quan hệ giữa một biến phụ thuộc Y và một biến độc lập X đơn lẻ thông qua phương trình đường thẳng:
Y = β₀ + β₁ × X + ε
Trong đó β₀ (Intercept / Hệ số chặn) là giao điểm của đường hồi quy với trục tung (giá trị của Y khi X = 0), và β₁ (Slope / Hệ số góc) là độ dốc của đường thẳng, phản ánh lượng thay đổi trung bình của Y khi X tăng thêm 1 đơn vị.
2. Hồi quy tuyến tính đa biến (Multiple Linear Regression)
Mở rộng mô hình với k biến độc lập (X₁, X₂,…, X_k) cùng tham gia giải thích cho biến phụ thuộc Y:
Y = β₀ + β₁×X₁ + β₂×X₂ +… + β_k×X_k + ε
Mỗi hệ số β_j đo lường tác động riêng phần của biến X_j lên Y trong điều kiện giữ nguyên tất cả các biến độc lập khác không thay đổi (giả định Ceteris Paribus).
“Giữa một đám mây điểm dữ liệu hỗn độn, Linear Regression tìm ra sợi chỉ đỏ xuyên suốt có tổng khoảng cách bình phương từ mọi điểm dữ liệu đến sợi chỉ đó là nhỏ bé và tối ưu.”
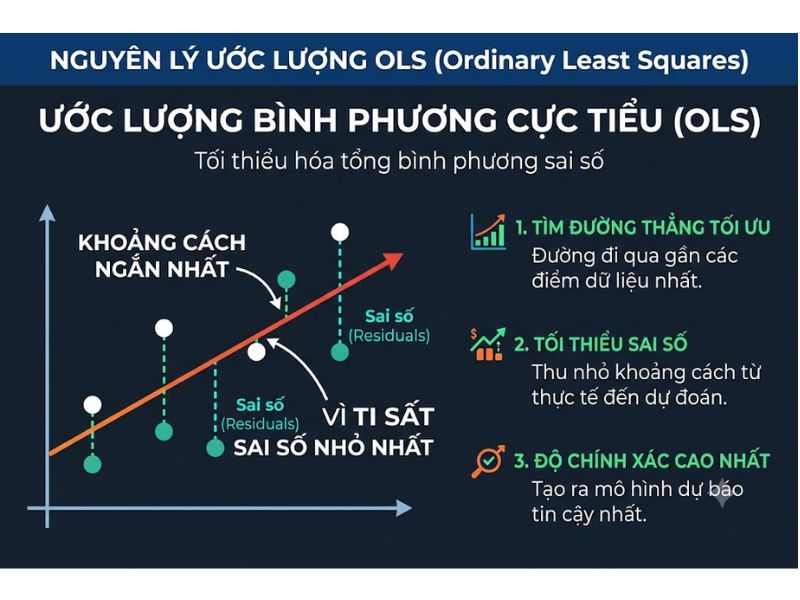
Nguyên lý ước lượng Bình phương cực tiểu thông thường (OLS – Ordinary Least Squares)
Làm thế nào để máy tính vẽ được đường thẳng đại diện chuẩn xác cho đám mây điểm dữ liệu? Phương pháp kinh điển do nhà toán học Carl Friedrich Gauss và Adrien-Marie Legendre phát triển là Phương pháp Bình phương cực tiểu (OLS):
- Với mỗi quan sát thứ i, độ lệch giữa giá trị thực tế y_i và giá trị dự báo trên đường thẳng ŷ_i = β₀ + β₁×x_i được gọi là Phần dư (Residual): e_i = y_i – ŷ_i.
- Nếu chỉ cộng tổng các phần dư Σ e_i, các sai số dương (nằm trên đường thẳng) và sai số âm (nằm dưới đường thẳng) sẽ tự triệt tiêu lẫn nhau về 0.
- Do đó, thuật toán OLS tiến hành bình phương từng phần dư lên rồi lấy tổng (RSS – Residual Sum of Squares) và giải bài toán vi phân tìm bộ hệ số (β₀, β₁,…, β_k) sao cho tổng bình phương phần dư đạt giá trị cực tiểu:
Tối thiểu hóa RSS = Σ (e_i)² = Σ (y_i – β₀ – β₁×x_{1i} -… – β_k×x_{ki})² → Min - Trong học máy (Machine Learning), đại lượng này tương đương với việc tối thiểu hóa Hàm mất mát sai số toàn phương trung bình (MSE – Mean Squared Error) bằng công thức nghiệm giải tích ma trận β = (X’X)⁻¹ X’Y hoặc thuật toán Hạ gradient (Gradient Descent) đối với dữ liệu lớn.
Định lý Gauss-Markov và 5 giả định sống còn của hồi quy tuyến tính
Để các hệ số ước lượng từ hồi quy tuyến tính đạt phẩm chất BLUE (Best Linear Unbiased Estimator – Ước lượng tuyến tính không chệch có phương sai nhỏ), mô hình bắt buộc phải thỏa mãn 5 giả định Gauss-Markov:
- Giả định tuyến tính (Linearity): Mối quan hệ thực tế giữa các biến độc lập và biến phụ thuộc phải có dạng đường thẳng tuyến tính. Kiểm tra qua biểu đồ phân tán Scatter Plot hoặc Residual Plot.
- Giả định kỳ vọng sai số bằng 0 và ngoại sinh nghiêm ngặt: E(ε_i | X) = 0. Các biến độc lập X không được tương quan với sai số ngẫu nhiên ε (không có hiện tượng nội sinh hay bỏ sót biến quan trọng).
- Giả định phương sai sai số không đổi (Homoscedasticity): Var(ε_i) = σ² không đổi tại mọi mức giá trị của X. Kiểm tra bằng đồ thị phần dư, kiểm định Breusch-Pagan hoặc kiểm định White.
- Giả định không có tự tương quan phần dư (No Autocorrelation): Cov(ε_i, ε_j) = 0 (với i ≠ j). Kiểm tra bằng thống kê Durbin-Watson (nằm trong khoảng 1.5 đến 2.5) hoặc kiểm định Breusch-Godfrey.
- Giả định không có đa cộng tuyến hoàn hảo (No Multicollinearity): Các biến độc lập không được phụ thuộc tuyến tính lẫn nhau. Kiểm tra qua hệ số phóng đại phương sai VIF < 2.0 (hoặc tối đa < 5.0). Ngoài ra, để kiểm định t-test và F-test chính xác trên mẫu nhỏ, phần dư cần tuân theo phân phối chuẩn (Normality).
Bảng tổng hợp cách đọc bảng kết quả Linear Regression chuẩn học thuật
Khi chạy Linear Regression trên SPSS, Stata, Python hay R, bạn cần tập trung vào 5 chỉ số báo cáo trọng tâm:
| Chỉ số báo cáo | Ký hiệu trên phần mềm | Tiêu chuẩn đạt yêu cầu | Ý nghĩa giải thích kết quả |
|---|---|---|---|
| Độ phù hợp mô hình | R Square / Adjusted R² | 0.30 ≤ R² ≤ 0.85 | Tỷ lệ % biến thiên của Y được giải thích bởi các biến X |
| Kiểm định độ khớp tổng thể | F-statistic (Prob > F / Sig.) | p-value < 0.05 | Khẳng định phương trình hồi quy có ý nghĩa thống kê tổng thể |
| Hệ số chưa chuẩn hóa | Unstandardized B (Coef.) | Mang dấu (+/-) đúng lý thuyết | Dùng để viết phương trình dự báo theo đơn vị gốc ban đầu |
| Hệ số chuẩn hóa | Standardized Beta | So sánh độ lớn tuyệt đối |Beta| | Xếp hạng thứ tự biến X nào tác động mạnh hay yếu lên Y |
| Kiểm định từng hệ số | t-statistic & p-value (Sig.) | |t| > 1.96 và p-value < 0.05 | Khẳng định biến X đó thực sự có tác động có ý nghĩa lên Y |
Sự khác biệt giữa Linear Regression trong Kinh tế lượng và trong Học máy (Machine Learning)
Cùng một thuật toán toán học, nhưng hai lĩnh vực sử dụng Linear Regression với trọng tâm khác nhau:
- Trong Kinh tế lượng & Nghiên cứu khoa học (Econometrics – SPSS, Stata, R): Tập trung vào Suy luận nhân quả và Kiểm định giả thuyết (Inference & Hypothesis Testing). Nhà nghiên cứu quan tâm sâu sắc đến tính không chệch của hệ số β, giá trị p-value, sai số chuẩn và việc thỏa mãn nghiêm ngặt 5 giả định OLS.
- Trong Học máy & Khoa học dữ liệu (Machine Learning – Python Scikit-learn): Tập trung vào Năng lực dự báo ngoài mẫu (Out-of-sample Prediction). Dữ liệu được chia thành tập huấn luyện (Train set – 80%) và tập kiểm thử (Test set – 20%). Để chống hiện tượng quá khớp (Overfitting) và đa cộng tuyến, các kỹ sư dữ liệu thường áp dụng các biến thể hồi quy có điều chuẩn như Ridge Regression (L2 Regularization), Lasso Regression (L1 Regularization) hoặc Elastic Net.
Câu hỏi thường gặp về Linear regression là gì (FAQ)
Biến phụ thuộc Y là biến nhị phân (0 và 1) thì có dùng Linear Regression được không?
Không nên dùng hồi quy tuyến tính thông thường vì giá trị dự báo có thể vượt ra ngoài khoảng [0; 1] và vi phạm giả định phương sai đồng đều; khi biến Y là nhị phân (0/1), bạn bắt buộc phải chuyển sang sử dụng Hồi quy Logistic (Logistic Regression) hoặc Probit.
Làm thế nào để đưa một biến có quan hệ đường cong (như Tuổi tác với Thu nhập) vào Linear Regression?
Bạn hoàn toàn có thể mô hình hóa quan hệ đường cong trong hồi quy tuyến tính bằng cách bổ sung thêm biến bình phương (như Tuổi² – Polynomial Regression) hoặc lấy logarit tự nhiên ln(X), miễn là phương trình vẫn giữ nguyên tính tuyến tính đối với các tham số β.
Cỡ mẫu tối thiểu để chạy Linear Regression là bao nhiêu?
Theo quy tắc thực nghiệm của Green (1991), cỡ mẫu tối thiểu cần đạt là N ≥ 50 + 8 × k (với k là số lượng biến độc lập) để kiểm định độ phù hợp tổng thể của mô hình, hoặc N ≥ 104 + k để kiểm định từng hệ số hồi quy riêng lẻ.
Kết luận và định hướng thực hành
Làm chủ Linear regression là gì là bước khởi đầu vững chắc cho mọi nhà nghiên cứu định lượng và chuyên gia phân tích dữ liệu trước khi tiến lên các mô hình cấu trúc SEM hay học sâu phức tạp. Để tải về bộ dữ liệu thực hành hồi quy tuyến tính kèm hướng dẫn từng bước trên SPSS, Stata và Python, mời quý bạn đọc tham khảo tại NCS Nguyễn Thanh Phương.
Giảng viên Nguyễn Thanh Phương là chuyên gia chuyên sâu về Nghiên cứu khoa học, Ứng dụng AI, Digital Marketing và Quản trị bản thân. Với kinh nghiệm giảng dạy thực chiến, tác giả trực tiếp hướng dẫn ứng dụng phương pháp luận và phân tích dữ liệu chuyên sâu cho người học nên được sinh viên gọi là Thầy giáo quốc dân. Mọi nội dung chia sẻ đều tuân thủ nguyên tắc khách quan, thực chứng và mang giá trị ứng dụng cao, hướng tới mục tiêu cốt lõi: “Làm bạn tốt hơn!