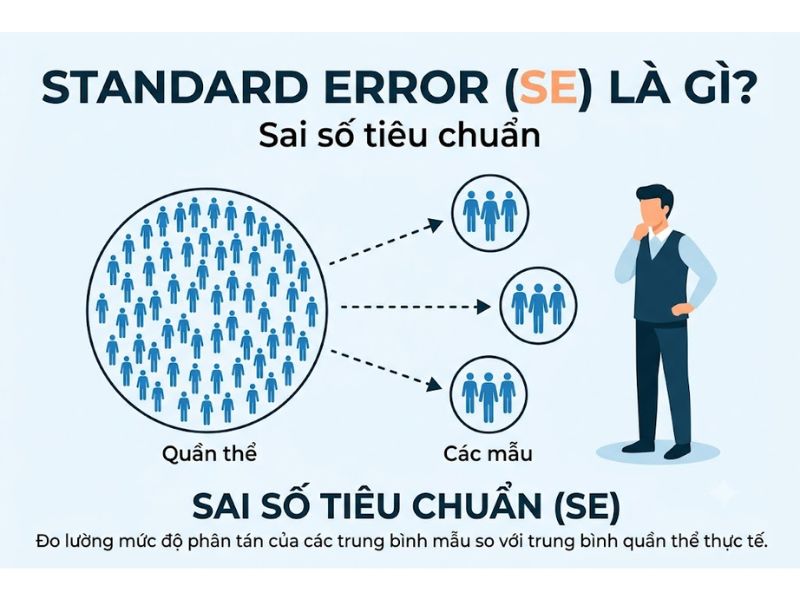
Standard Error là gì (Sai số chuẩn – SE) là một đại lượng thống kê suy diễn đo lường mức độ biến thiên và độ phân tán của một tham số ước lượng mẫu (như giá trị trung bình mẫu, tỷ lệ mẫu hoặc hệ số hồi quy) xung quanh giá trị tham số thực của tổng thể qua các lần chọn mẫu lặp lại. Trong nghiên cứu định lượng và phân tích kinh tế lượng, sai số chuẩn đóng vai trò là thước đo phản ánh độ chính xác của phép ước lượng; sai số chuẩn càng nhỏ chứng tỏ thống kê mẫu càng tiệm cận gần với giá trị thực của tổng thể và mức độ tin cậy của kết luận khoa học càng cao.
Bản chất lý thuyết của Sai số chuẩn và Phân phối chọn mẫu (Sampling Distribution)
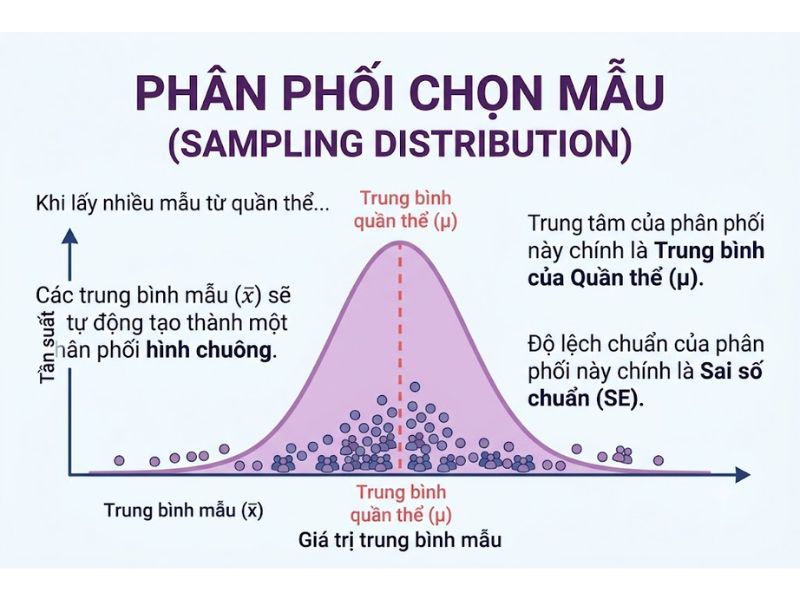
Để hiểu thấu đáo Standard Error là gì, nhà nghiên cứu cần nắm vững cơ chế hình thành của Phân phối chọn mẫu (Sampling Distribution) trong thống kê học:
- Trong thực tế nghiên cứu kinh tế – xã hội, chúng ta hiếm khi có đủ nguồn lực để điều tra toàn bộ tổng thể (Population – N). Thay vào đó, ta rút ra một mẫu ngẫu nhiên cỡ n và tính toán được một giá trị trung bình mẫu x̄₁.
- Nếu một nhà nghiên cứu khác cũng rút một mẫu ngẫu nhiên cỡ n từ cùng tổng thể đó, họ sẽ thu được giá trị trung bình mẫu x̄₂ hơi khác so với x̄₁. Nếu quá trình rút mẫu độc lập này được lặp lại hàng nghìn lần (k lần), chúng ta sẽ có một tập hợp gồm hàng nghìn giá trị trung bình mẫu: x̄₁, x̄₂,…, x̄_k.
- Theo Định lý Giới hạn Trung tâm (Central Limit Theorem – CLT), khi cỡ mẫu n đủ lớn (thường n ≥ 30), tập hợp các giá trị trung bình mẫu này sẽ tạo thành một phân phối chuẩn có trung bình bằng đúng trung bình tổng thể μ.
- Sai số chuẩn (Standard Error – SE) chính là độ lệch chuẩn của phân phối chọn mẫu lý thuyết đó. Nó cho biết nếu ta lấy mẫu một lần nữa thì giá trị ước lượng mới sẽ chệch đi trung bình bao nhiêu đơn vị so với tham số tổng thể.
“Nếu Độ lệch chuẩn (Standard Deviation) đo lường sự phân tán tự nhiên giữa các cá nhân bên trong một mẫu khảo sát, thì Sai số chuẩn (Standard Error) đo lường độ chuẩn xác của chiếc ống kính mẫu khảo sát đó khi phóng chiếu lên toàn bộ tổng thể.”
Công thức toán học tính Standard Error trong các bài toán thống kê
Tùy thuộc vào tham số đang được ước lượng, công thức tính sai số chuẩn có dạng cụ thể như sau:
1. Sai số chuẩn của giá trị trung bình mẫu (Standard Error of the Mean – SEM)
Khi độ lệch chuẩn của tổng thể (σ) chưa biết và được ước lượng bằng độ lệch chuẩn mẫu (s), công thức tính sai số chuẩn của trung bình mẫu là:
SE(x̄) = s / √n
Trong đó s là độ lệch chuẩn của mẫu khảo sát và √n là căn bậc hai của quy mô cỡ mẫu. Công thức này chứng minh quy luật căn bậc hai nghịch đảo: Khi kích thước mẫu n tăng lên gấp 4 lần, sai số chuẩn SE sẽ giảm đi một nửa (giảm 50%), giúp độ chính xác của ước lượng tăng lên gấp đôi.
2. Sai số chuẩn của tỷ lệ mẫu (Standard Error of a Proportion – SEP)
Đối với các biến định tính nhị phân có tỷ lệ xuất hiện trong mẫu là p (với 0 < p < 1):
SE(p) = √[ p × (1 – p) / n ]
3. Sai số chuẩn của hệ số góc hồi quy (Standard Error of Regression Slope – SE(β₁))
Trong hồi quy tuyến tính OLS đơn biến Y = β₀ + β₁×X + ε, sai số chuẩn của hệ số góc β₁ được tính bằng:
SE(β₁) = √[ RSS / (n – 2) ] / √[ Σ (x_i – x̄)² ]
Phương trình này cho thấy sai số chuẩn của hệ số hồi quy sẽ càng nhỏ khi phương sai phần dư (RSS) càng nhỏ và độ biến thiên của biến độc lập X càng rộng.
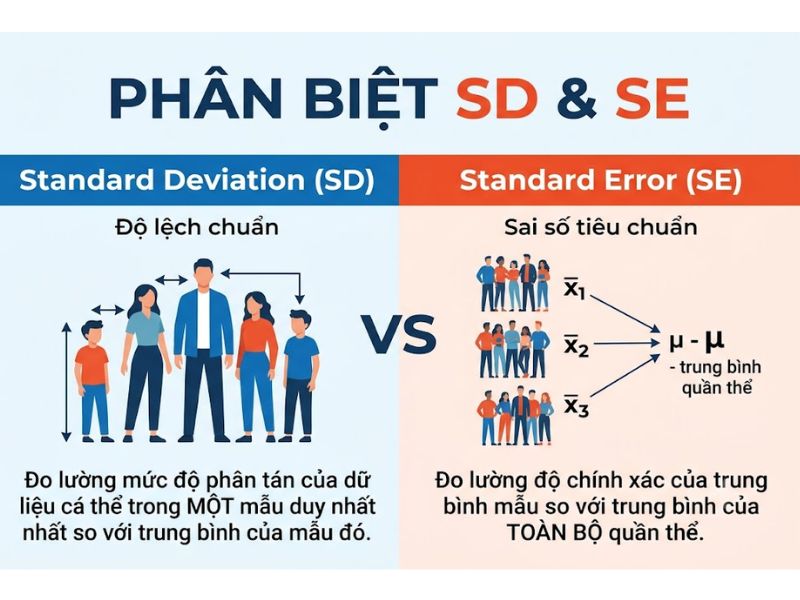
Bảng so sánh đối chuẩn giữa Standard Error (SE) và Standard Deviation (SD)
Việc phân biệt rạch ròi giữa SE và SD là yêu cầu bắt buộc khi trình bày báo cáo nghiên cứu quốc tế:
| Tiêu chí phân biệt | Standard Deviation (Độ lệch chuẩn – SD) | Standard Error (Sai số chuẩn – SE) |
|---|---|---|
| Thuật ngữ phân loại | Thống kê mô tả (Descriptive Statistics) | Thống kê suy diễn (Inferential Statistics) |
| Đối tượng phản ánh | Độ phân tán của các quan sát cá thể quanh trung bình mẫu | Độ biến thiên của trung bình mẫu quanh trung bình tổng thể |
| Công thức tính toán | s = √[ Σ(x_i – x̄)² / (n – 1) ] | SE = s / √n |
| Ảnh hưởng khi tăng cỡ mẫu n | Không giảm mà hội tụ ổn định về độ lệch chuẩn tổng thể σ | Giảm dần tiến về 0 khi cỡ mẫu n tiến ra vô cùng |
| Mối quan hệ độ lớn | Luôn lớn hơn SE (khi n > 1) | Luôn nhỏ hơn SD (bằng SD chia cho √n) |
| Ứng dụng báo cáo | Mô tả đặc điểm mẫu khảo sát (Bảng Descriptive) | Tính t-statistic, p-value và khoảng tin cậy 95% |
Ứng dụng trọng tâm của Standard Error trong Kiểm định giả thuyết và Hồi quy
Trong mọi phần mềm thống kê như SPSS, Stata, SmartPLS hay R, cột Std. Error là cầu nối trực tiếp dẫn đến hai quyết định thống kê:
- Tính giá trị thống kê t (t-statistic) và p-value: Để kiểm định xem một hệ số hồi quy β có thực sự khác 0 hay không, phần mềm lấy hệ số ước lượng chia cho sai số chuẩn của nó:
t-statistic = β / SE(β)
Nếu sai số chuẩn SE nhỏ, tỷ số t-statistic sẽ lớn (vượt ngưỡng 1.96), kéo theo giá trị p-value nhỏ hơn 0.05 và giúp giả thuyết nghiên cứu được chấp nhận vững chắc. - Thiết lập Khoảng tin cậy 95% (95% Confidence Interval): Sai số chuẩn xác định biên độ sai số (Margin of Error) cho phép ước lượng khoảng:
Khoảng tin cậy 95% = [ β – 1.96 × SE(β) ; β + 1.96 × SE(β) ]
Nếu khoảng tin cậy 95% này không chứa giá trị 0, nhà nghiên cứu kết luận tác động của biến số có ý nghĩa thống kê ở mức 5%.
Hiện tượng Sai số chuẩn bị chệch và Kỹ thuật hiệu chỉnh Robust Standard Errors
Trong phân tích kinh tế lượng thực nghiệm, có hai khuyết tật mô hình làm hỏng công thức tính sai số chuẩn cổ điển:
- Đa cộng tuyến cao (Multicollinearity): Khi các biến độc lập tương quan mạnh với nhau (VIF > 5), sai số chuẩn SE(β) sẽ bị phình to bất thường, làm cho t-statistic sụt giảm và khiến biến số mất đi ý nghĩa thống kê dù trên thực tế biến đó rất quan trọng.
- Phương sai sai số thay đổi (Heteroscedasticity) và Tự tương quan: Làm cho công thức tính SE của OLS bị chệch (thường bị ước lượng thấp hơn thực tế), gây ra hiện tượng “ý nghĩa thống kê giả tạo”. Để khắc phục, các nhà kinh tế lượng sử dụng Sai số chuẩn vững của White (Huber-White Robust Standard Errors) bằng tùy chọn , robust hoặc Sai số chuẩn phân cụm (Clustered Standard Errors) bằng tùy chọn , vce(cluster id) trên Stata, hay sử dụng Bootstrap Standard Errors trên SmartPLS 4.
Nghiên cứu tình huống tính toán và diễn giải Standard Error thực tế
Một nghiên cứu khảo sát mức chi tiêu mua sắm trực tuyến hàng tháng của mẫu n = 400 người tiêu dùng tại TP. Hồ Chí Minh thu được trung bình mẫu x̄ = 4.50 triệu đồng và độ lệch chuẩn mẫu s = 2.00 triệu đồng:
- Độ lệch chuẩn (SD = 2.00 triệu): Phản ánh mức chi tiêu giữa các cá nhân trong mẫu chênh lệch nhau khá rộng quanh mức 4.50 triệu đồng.
- Sai số chuẩn của trung bình (SE): SE = s / √n = 2.00 / √400 = 2.00 / 20 = 0.10 triệu đồng (100.000 đồng).
- Khoảng tin cậy 95% cho trung bình tổng thể: 4.50 ± (1.96 × 0.10) = [4.304 ; 4.696] triệu đồng. Nhà nghiên cứu khẳng định với độ tin cậy 95%, mức chi tiêu trung bình thực tế của toàn bộ người tiêu dùng tại thành phố nằm trong khoảng từ 4.304 triệu đến 4.696 triệu đồng/tháng.
Câu hỏi thường gặp về Standard Error là gì (FAQ)
Trong bảng thống kê mô tả của luận văn, nên báo cáo Mean ± SD hay Mean ± SE?
Theo chuẩn mực trình bày của APA và các tạp chí khoa học quốc tế, khi mô tả đặc điểm dữ liệu mẫu ban đầu bạn luôn phải báo cáo Mean ± SD; còn SE chỉ được báo cáo khi trình bày bảng kết quả ước lượng tham số hồi quy hoặc so sánh suy diễn.
Tại sao khi chạy Bootstrap 5.000 mẫu trên SmartPLS, cột Standard Deviation (STDEV) lại chính là Standard Error?
Bởi vì theo đúng định nghĩa lý thuyết, độ lệch chuẩn của 5.000 mẫu con tái lấy mẫu (Sampling distribution) chính là Sai số chuẩn (Standard Error) của hệ số đường dẫn gốc; SmartPLS lấy trực tiếp giá trị Original Sample chia cho cột STDEV này để ra cột t-statistics.
Làm thế nào để giảm sai số chuẩn SE trong nghiên cứu thực nghiệm?
Có hai giải pháp thực tế: Một là tăng quy mô kích thước mẫu khảo sát n; hai là chuẩn hóa quy trình thiết kế bảng hỏi và đo lường để giảm thiểu phương sai nhiễu s.
Kết luận và định hướng ứng dụng
Nắm vững bản chất Standard Error là gì giúp nhà nghiên cứu kiểm soát chặt chẽ độ chính xác của các ước lượng thống kê, đọc hiểu thấu đáo bảng kết quả hồi quy và bảo vệ vững chắc các giả thuyết nghiên cứu trước hội đồng khoa học. Để tải về bảng tính Excel thực hành tính toán SE, khoảng tin cậy và bộ lệnh Robust SE trên Stata, mời quý bạn đọc tham khảo tại thầy Phương.
Giảng viên Nguyễn Thanh Phương là chuyên gia chuyên sâu về Nghiên cứu khoa học, Ứng dụng AI, Digital Marketing và Quản trị bản thân. Với kinh nghiệm giảng dạy thực chiến, tác giả trực tiếp hướng dẫn ứng dụng phương pháp luận và phân tích dữ liệu chuyên sâu cho người học nên được sinh viên gọi là Thầy giáo quốc dân. Mọi nội dung chia sẻ đều tuân thủ nguyên tắc khách quan, thực chứng và mang giá trị ứng dụng cao, hướng tới mục tiêu cốt lõi: “Làm bạn tốt hơn!