Multiple regression analysis là gì (Phân tích hồi quy bội / hồi quy đa biến) là một kỹ thuật thống kê định lượng mạnh mẽ dùng để kiểm tra mối quan hệ tuyến tính giữa một biến phụ thuộc liên tục duy nhất (Y) và hai hay nhiều biến độc lập (X₁, X₂, …, X_k). Trong nghiên cứu kinh tế lượng, tài chính doanh nghiệp và khoa học xã hội, hồi quy đa biến là công cụ phân tích trụ cột giúp các nhà nghiên cứu không chỉ dự báo chuẩn xác giá trị của biến kết quả mà còn bóc tách mức độ đóng góp độc lập của từng biến nguyên nhân trong điều kiện kiểm soát các yếu tố gây nhiễu khác.
Phương trình toán học tổng quát và ý nghĩa các tham số ước lượng
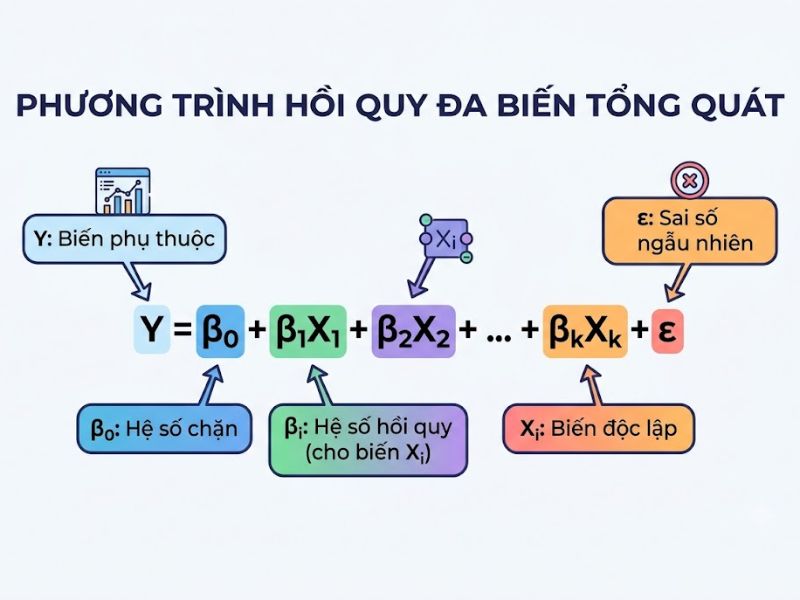
Mô hình hồi quy tuyến tính đa biến tổng thể được biểu diễn dưới dạng phương trình toán học:
Y = β₀ + β₁×X₁ + β₂×X₂ + … + β_k×X_k + ε
Trong đó:
- Y: Biến phụ thuộc (Dependent Variable), đại diện cho hiện tượng cần được giải thích hoặc dự báo (ví dụ: Doanh thu, Lợi nhuận, Điểm số hài lòng).
- X₁, X₂, …, X_k: Tập hợp các biến độc lập (Independent Variables) hoặc biến giải thích (ví dụ: Chi phí quảng cáo, Giá bán, Thu nhập khách hàng).
- β₀ (Hệ số chặn / Intercept): Giá trị kỳ vọng của biến phụ thuộc Y khi tất cả các biến độc lập trong mô hình đều đồng thời nhận giá trị bằng 0.
- β_j (Hệ số hồi quy riêng phần / Partial Regression Coefficients): Đo lường mức độ thay đổi kỳ vọng của biến phụ thuộc Y khi biến độc lập X_j tăng thêm một đơn vị, với điều kiện giữ nguyên tất cả các biến độc lập khác không đổi (Ceteris Paribus). Đây là đặc tính ưu việt giúp bóc tách tác động thuần túy của từng nhân tố.
- ε (Sai số ngẫu nhiên / Error term): Đại diện cho sai số đo lường và ảnh hưởng của toàn bộ các yếu tố bên ngoài chưa được đưa vào mô hình.
“Hồi quy đơn biến cho bạn thấy mối tương quan thô, trong khi hồi quy đa biến trao cho bạn chiếc kính lọc khoa học để nhìn thấy tác động thực chất của từng nhân tố sau khi đã loại bỏ mọi yếu tố gây nhiễu xung quanh.”
Các tiêu chuẩn đánh giá chất lượng mô hình hồi quy đa biến
Khi đọc bảng kết quả hồi quy trên các phần mềm như SPSS, Stata hay R, nhà nghiên cứu cần đánh giá 3 lớp tiêu chuẩn thống kê:
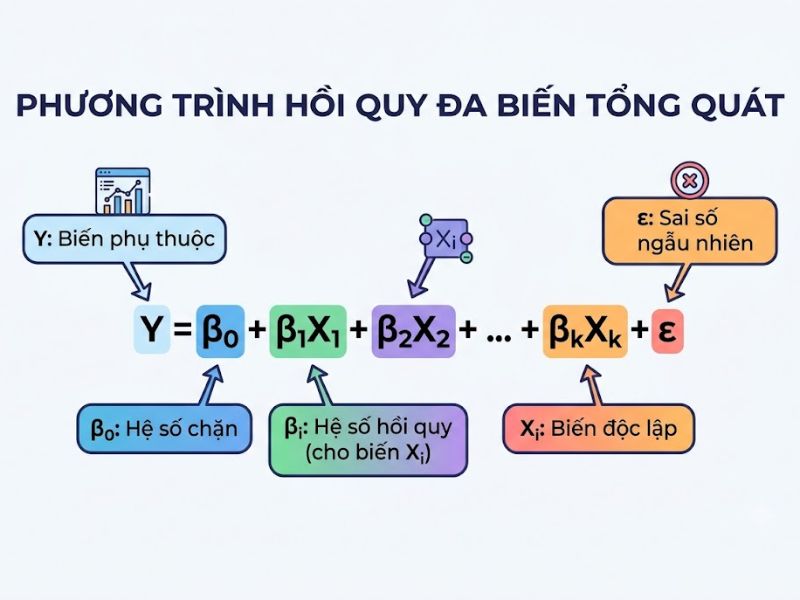
1. Đánh giá độ phù hợp tổng thể của mô hình qua hệ số R² và R² hiệu chỉnh
Hệ số xác định R² phản ánh tỷ lệ phương sai của biến phụ thuộc Y được giải thích chung bởi tập hợp các biến độc lập. Tuy nhiên, trong hồi quy đa biến, giá trị R² có xu hướng tăng lên một cách giả tạo mỗi khi bạn bổ sung thêm một biến độc lập mới vào mô hình, ngay cả khi biến đó không có ý nghĩa thực tế. Do đó, bạn bắt buộc phải sử dụng Hệ số R² hiệu chỉnh (Adjusted R-squared):
R²_adj = 1 – [(1 – R²) × (n – 1) / (n – k – 1)]
Chỉ số R² hiệu chỉnh đã phạt việc đưa thêm các biến số thừa thãi, giúp đánh giá thực chất năng lực giải thích của mô hình.
2. Kiểm định ý nghĩa tổng thể của mô hình qua kiểm định F (ANOVA)
Kiểm định giả thuyết không H₀: β₁ = β₂ = … = β_k = 0 (toàn bộ các biến độc lập đồng thời không có tác động lên Y). Nếu giá trị p-value của kiểm định F nhỏ hơn 0.05, ta bác bỏ H₀ và kết luận mô hình hồi quy có ý nghĩa thống kê tổng thể vững chắc.
3. Kiểm định ý nghĩa của từng hệ số hồi quy riêng phần qua kiểm định t
Kiểm tra xem từng biến độc lập X_j có thực sự tác động lên Y hay không: Nếu p-value của kiểm định t nhỏ hơn 0.05 (hoặc |t-statistic| > 1.96), hệ số hồi quy β_j có ý nghĩa thống kê khác 0 ở mức tin cậy 95%.
Bảng tổng hợp các tiêu chí đánh giá mô hình hồi quy đa biến OLS
Dưới đây là bảng tra cứu các chỉ số báo cáo chuẩn học thuật:
| Chỉ số thống kê | Mục đích kiểm tra | Ngưỡng đạt yêu cầu | Kết luận khoa học |
|---|---|---|---|
| R² hiệu chỉnh (Adj R²) | Đo lường năng lực giải thích thực tế | Càng cao càng tốt (0.30 – 0.70) | Tỷ lệ phương sai Y được mô hình giải thích |
| F-statistic (ANOVA) | Độ phù hợp của toàn bộ phương trình | p-value < 0.05 (Sig < 0.05) | Mô hình có giá trị suy luận thống kê |
| t-statistic & p-value | Ý nghĩa của từng biến độc lập | |t| > 1.96, p < 0.05 | Biến độc lập có tác động thực sự đến Y |
| Hệ số Beta chuẩn hóa | So sánh mức độ tác động tương đối | Hệ số có trị tuyệt đối lớn | Xác định biến số nào đóng vai trò mạnh mẽ |
| Hệ số VIF (Collinearity) | Kiểm tra hiện tượng đa cộng tuyến | VIF < 2.0 (tối đa < 5.0) | Các biến độc lập không trùng lặp thông tin |
5 giả định OLS căn bản bắt buộc phải kiểm tra trong hồi quy đa biến
Để phương pháp ước lượng bình phương nhỏ nhất OLS cho kết quả chuẩn xác (đạt tính chất BLUE – Best Linear Unbiased Estimator), mô hình cần thỏa mãn 5 giả định:
- Tính tuyến tính của các tham số (Linearity): Mối quan hệ giữa biến phụ thuộc và các biến độc lập phải tuân theo dạng hàm tuyến tính.
- Không có hiện tượng đa cộng tuyến hoàn hảo (No Multicollinearity): Giữa các biến độc lập không được có mối quan hệ tương quan tuyến tính quá chặt chẽ (VIF < 5.0).
- Phương sai sai số không đổi (Homoscedasticity): Phương sai của các phần dư phải đồng nhất tại mọi mức giá trị của các biến dự báo.
- Không có tự tương quan giữa các phần dư (No Autocorrelation): Các phần dư không được tương quan chuỗi với nhau (kiểm định qua chỉ số Durbin-Watson trong khoảng từ 1.5 đến 2.5).
- Phần dư tuân theo phân phối chuẩn (Normality of Residuals): Phần dư có phân phối tiệm cận chuẩn với trung bình bằng 0.
Kỹ thuật hồi quy từng bước (Stepwise Regression) và những lưu ý phương pháp luận
Khi triển khai Multiple regression analysis là gì trên các tập dữ liệu có hàng chục biến độc lập tiềm năng, các phần mềm cung cấp các thuật toán lựa chọn biến tự động:
- Chọn dần tiến lên (Forward Selection): Bắt đầu từ mô hình rỗng không có biến nào, lần lượt bổ sung từng biến độc lập có mức đóng góp ý nghĩa thống kê cao nhất (p < 0.05) cho đến khi không còn biến nào đạt chuẩn.
- Loại dần lùi lại (Backward Elimination): Bắt đầu bằng mô hình chứa toàn bộ các biến độc lập, sau đó lần lượt loại bỏ từng biến có p-value lớn nhất (kém ý nghĩa nhất, thường p > 0.10) cho đến khi toàn bộ các biến còn lại đều có ý nghĩa.
- Cảnh báo học thuật: Các chuyên gia kinh tế lượng khuyến cáo không nên lạm dụng các thuật toán lựa chọn biến máy móc thuần túy số học này; việc lựa chọn biến đưa vào phương trình hồi quy luôn phải xuất phát từ cơ sở lý thuyết kinh tế vững chắc (Theory-driven) thay vì chạy theo số liệu ngẫu nhiên (Data-driven).
Nghiên cứu tình huống ứng dụng hồi quy đa biến trong định giá bất động sản
Một công ty nghiên cứu thị trường phân tích các yếu tố quyết định Giá bán căn hộ chung cư (Y, tính bằng triệu đồng/m²) dựa trên tập dữ liệu khảo sát 300 dự án:
- Phương trình ước lượng thu được: Giá = 15.2 + 0.45×DiệnTích – 1.85×KhoảngCách + 3.20×TiệnÍch + 0.12×Tầng
- Diễn giải ý nghĩa thực tiễn:
- Hệ số của Khoảng cách (đến trung tâm thành phố) là -1.85 (p < 0.001): Trong điều kiện các yếu tố khác không đổi, cứ mỗi km xa trung tâm hơn thì giá căn hộ giảm bình quân 1.85 triệu đồng/m².
- Hệ số Tiện ích nội khu là +3.20 (p < 0.001): Cứ tăng thêm một cấp độ tiện ích (hồ bơi, công viên, trường học), giá bán tăng thêm 3.20 triệu đồng/m².
- Mô hình đạt R² hiệu chỉnh = 0.684, kiểm định F có p < 0.001, và các hệ số VIF đều dưới 1.8; chứng minh mô hình có độ tin cậy và khả năng dự báo giá trị thị trường xuất sắc.
Câu hỏi thường gặp về Multiple Regression Analysis là gì (FAQ)
Nên căn cứ vào hệ số hồi quy chưa chuẩn hóa (B) hay chuẩn hóa (Beta) để so sánh?
Để so sánh xem biến độc lập nào có tác động mạnh hơn lên biến phụ thuộc, bạn bắt buộc phải nhìn vào hệ số Beta chuẩn hóa (Standardized Beta) vì các biến số ban đầu có đơn vị đo lường khác nhau.
Nếu một biến độc lập có tương quan đơn với Y nhưng khi đưa vào hồi quy đa biến lại có p > 0.05 thì sao?
Hiện tượng này xảy ra khi tác động của biến đó đã bị các biến độc lập khác trong mô hình chia sẻ hoặc kiểm soát hết; biến đó không mang lại thêm giá trị giải thích độc lập nào mới.
Hồi quy đa biến có phân tích được biến độc lập là biến phân loại (như Giới tính, Khu vực) không?
Có thể thực hiện rất tốt bằng cách tạo ra các Biến giả (Dummy Variables) nhận giá trị 0 hoặc 1 trước khi đưa vào phương trình hồi quy.
Kết luận và khuyến nghị thực hành
Nắm vững phương pháp Multiple regression analysis là gì giúp nhà nghiên cứu và nhà quản trị biến những tập dữ liệu thô phức tạp thành các phương trình dự báo chuẩn xác và các quyết định kinh doanh chiến lược. Để tải về các tệp dữ liệu mẫu SPSS/Stata và bảng hướng dẫn đọc output hồi quy đa biến chi tiết, mời quý bạn đọc truy cập thầy Nguyễn Thanh Phương.
Giảng viên Nguyễn Thanh Phương là chuyên gia chuyên sâu về Nghiên cứu khoa học, Ứng dụng AI, Digital Marketing và Quản trị bản thân. Với kinh nghiệm giảng dạy thực chiến, tác giả trực tiếp hướng dẫn ứng dụng phương pháp luận và phân tích dữ liệu chuyên sâu cho người học nên được sinh viên gọi là Thầy giáo quốc dân. Mọi nội dung chia sẻ đều tuân thủ nguyên tắc khách quan, thực chứng và mang giá trị ứng dụng cao, hướng tới mục tiêu cốt lõi: “Làm bạn tốt hơn!