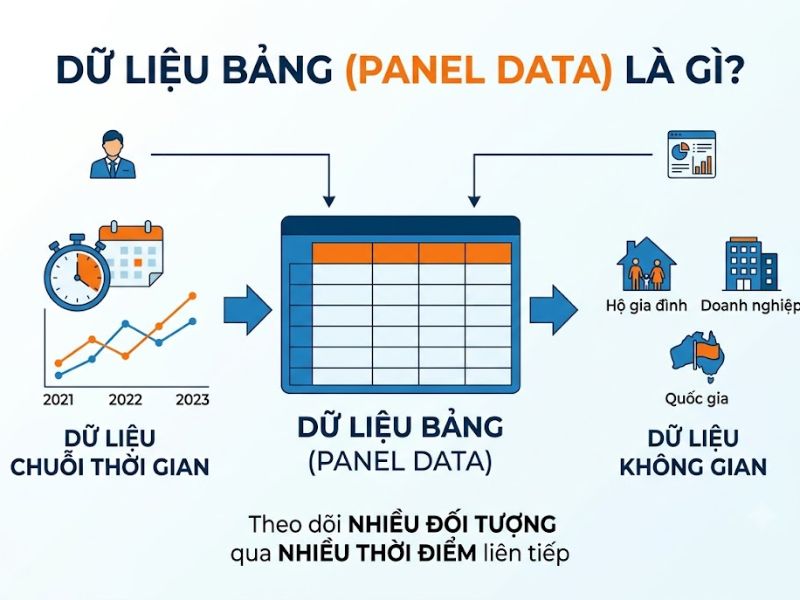
Dữ liệu bảng là gì (Panel Data hoặc Longitudinal Data) là một cấu trúc dữ liệu hai chiều kết hợp đồng thời cả dữ liệu chéo theo không gian (Cross-sectional Data) và dữ liệu theo chuỗi thời gian (Time-series Data), trong đó cùng một tập hợp các thực thể (như doanh nghiệp, ngân hàng, quốc gia, hộ gia đình) được theo dõi và đo lường lặp đi lặp lại qua nhiều thời kỳ liên tiếp. Trong nghiên cứu tài chính doanh nghiệp, kế toán và kinh tế vĩ mô hiện đại, dữ liệu bảng đã trở thành chuẩn mực dữ liệu nền tảng nhờ khả năng kiểm soát sự khác biệt không quan sát được giữa các đối tượng và cung cấp lượng thông tin thực nghiệm phong phú vượt trội.
Bản chất cấu trúc hai chiều và ký hiệu toán học của dữ liệu bảng
Để nhận diện rõ Dữ liệu bảng là gì, chúng ta đặt nó trong sự đối chiếu với hai dạng dữ liệu một chiều truyền thống:
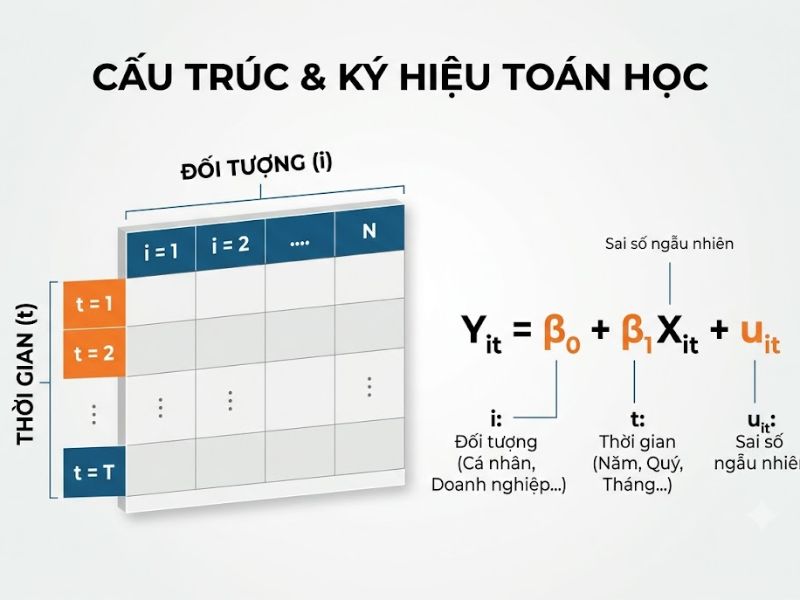
- Dữ liệu chéo (Cross-sectional Data – Ký hiệu Y_i): Khảo sát nhiều đối tượng i = 1, 2,…, N tại một thời điểm đơn lẻ (ví dụ: Báo cáo tài chính của 300 công ty niêm yết trong riêng năm 2025).
- Dữ liệu chuỗi thời gian (Time-series Data – Ký hiệu Y_t): Theo dõi một đối tượng đơn lẻ qua nhiều mốc thời gian t = 1, 2,…, T (ví dụ: Chỉ số lạm phát của Việt Nam qua 30 năm từ 1995 đến 2025).
- Dữ liệu bảng (Panel Data – Ký hiệu Y_{it}): Theo dõi N đối tượng qua T thời kỳ, tạo ra tổng số quan sát là N × T (trong trường hợp bảng cân đối). Mỗi điểm dữ liệu Y_{it} luôn mang hai chỉ số định danh: chỉ số thực thể không gian i (Individual ID) và chỉ số thời gian t (Time Period).
“Nếu dữ liệu chéo là một bức ảnh chụp nhanh nhiều người tại một khoảnh khắc, còn chuỗi thời gian là cuốn phim quay một người suốt cuộc đời, thì dữ liệu bảng chính là bộ phim điện ảnh đa tuyến theo dõi hành trình của hàng trăm nhân vật qua nhiều năm tháng.”
Các ưu thế vượt trội của dữ liệu bảng trong phân tích kinh tế lượng
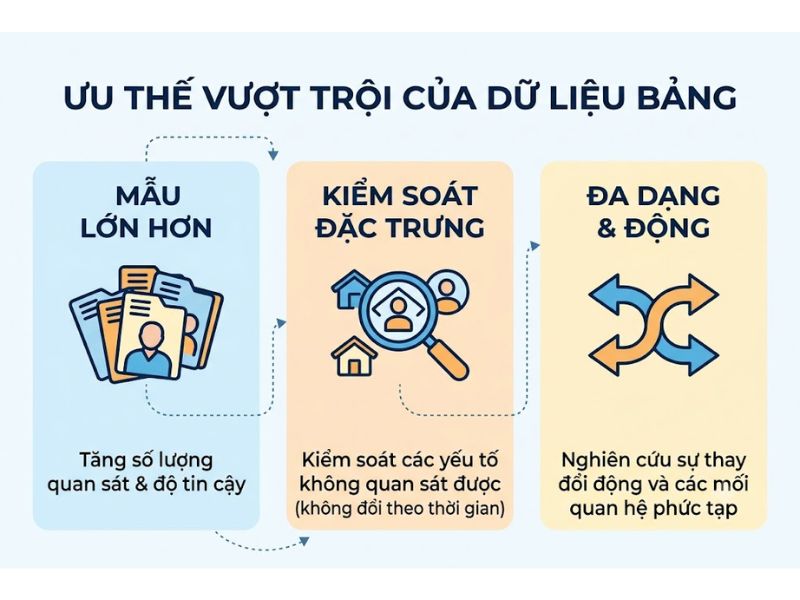
Theo giáo trình kinh tế lượng kinh điển của Baltagi (2021) và Wooldridge (2020), việc sử dụng dữ liệu bảng mang lại 5 lợi ích phương pháp luận to lớn:
- Kiểm soát tính không đồng đều cá thể (Controlling for Individual Heterogeneity): Mỗi doanh nghiệp hay quốc gia đều có những đặc tính nội tại riêng biệt không thể đo lường trực tiếp (như văn hóa quản trị, uy tín lịch sử, vị trí địa lý). Dữ liệu chéo không thể tách biệt các yếu tố này làm phát sinh hiện tượng chệch do bỏ sót biến, trong khi dữ liệu bảng khử sạch hoàn toàn các yếu tố bất biến theo thời gian này.
- Gia tăng bậc tự do và giảm thiểu hiện tượng đa cộng tuyến: Sự kết hợp hai chiều N và T giúp mở rộng quy mô mẫu lên gấp nhiều lần, tạo ra sự biến thiên dữ liệu phong phú, giảm hiện tượng đa cộng tuyến giữa các biến độc lập và thu hẹp sai số chuẩn ước lượng.
- Phân tích động thái điều chỉnh theo thời gian (Dynamics of Adjustment): Cho phép nghiên cứu quá trình thay đổi hành vi, tốc độ thích ứng của doanh nghiệp trước các chính sách thuế hoặc khủng hoảng kinh tế.
- Xử lý hiệu quả bài toán nội sinh (Endogeneity): Cung cấp các biến công cụ nội tại (thông qua các biến trễ trong mô hình Dynamic Panel GMM) mà không cần vất vả tìm kiếm biến công cụ ngoại lai từ bên ngoài.
- Tránh sai lệch do tổng hợp dữ liệu (Aggregation Bias): Phân tích trực tiếp ở cấp độ vi mô từng doanh nghiệp/cá nhân thay vì cộng gộp thành số liệu trung bình toàn ngành.
Phân loại các dạng cấu trúc dữ liệu bảng thực tế
Tùy thuộc vào tính đầy đủ của số liệu và tương quan giữa N và T, dữ liệu bảng được chia thành các nhóm sau:
1. Bảng cân đối (Balanced Panel) và Bảng không cân đối (Unbalanced Panel)
- Bảng cân đối: Mọi đối tượng i đều được quan sát đầy đủ trong tất cả T thời kỳ (không có bất kỳ năm nào bị khuyết số liệu). Tổng số quan sát đúng bằng N × T.
- Bảng không cân đối: Một số đối tượng bị khuyết dữ liệu ở một vài năm (do công ty mới lên sàn chứng khoán muộn, hoặc bị hủy niêm yết, sáp nhập giữa chừng). Các phần mềm hiện đại như Stata và R đều xử lý tự động dữ liệu bảng không cân đối mà không làm mất tính vững của ước lượng.
2. Bảng ngắn (Short / Micro Panel) và Bảng dài (Long / Macro Panel)
- Bảng ngắn (N lớn, T nhỏ): Số lượng thực thể N rất lớn (hàng trăm công ty) nhưng số năm T ngắn (từ 5 đến 10 năm). Đây là dạng dữ liệu phổ biến trong luận văn tài chính doanh nghiệp, sử dụng các mô hình FEM, REM và System GMM.
- Bảng dài (N nhỏ, T lớn): Số lượng thực thể ít (ví dụ 10 quốc gia ASEAN) nhưng chuỗi thời gian kéo dài (30 – 40 năm). Đòi hỏi phải kiểm tra tính dừng bảng (Panel Unit Root) và đồng liên kết bảng.
Bảng so sánh 4 phương pháp ước lượng mô hình dữ liệu bảng kinh điển
Phương trình dữ liệu bảng tổng quát có dạng: Y_{it} = β₀ + β × X_{it} + u_i + ε_{it} (trong đó u_i là hiệu ứng đặc thù riêng của từng cá thể). Dưới đây là bảng đối chuẩn 4 mô hình ước lượng:
| Mô hình ước lượng | Bản chất xử lý hiệu ứng cá thể (u_i) | Giả định về tương quan Cov(u_i, X_{it}) | Kiểm định lựa chọn mô hình |
|---|---|---|---|
| 1. Pooled OLS (Hồi quy gộp) | Bỏ qua hoàn toàn u_i, coi mọi công ty giống hệt nhau | Giả định không có hiệu ứng cá thể | F-test (so với FEM) và Breusch-Pagan (so với REM) |
| 2. FEM (Fixed Effects – Tác động cố định) | Coi u_i là tham số cố định riêng biệt của từng cá thể | Cho phép u_i tương quan tự do với X_{it} | Kiểm định Hausman (p < 0.05 chọn FEM) |
| 3. REM (Random Effects – Tác động ngẫu nhiên) | Coi u_i là một biến ngẫu nhiên thuộc phần dư tổng hợp | Bắt buộc u_i không tương quan với X_{it} | Kiểm định Hausman (p > 0.05 chọn REM) |
| 4. SGMM (System GMM – Bảng động) | Có thêm biến trễ phụ thuộc Y_{i,t-1} ở vế phải | Xử lý triệt để nội sinh động bằng biến công cụ trễ | Kiểm định Arellano-Bond AR(2) và Hansen Test |
Hướng dẫn tổ chức dữ liệu dạng Long Format và khai báo trên Stata
Để phần mềm Stata phân tích được dữ liệu bảng, tệp Excel cần sắp xếp theo cấu trúc Dạng dọc (Long Format): Cột 1 là mã đối tượng (FirmID), Cột 2 là năm (Year), các cột tiếp theo là các biến tài chính (ROA, Size, Leverage). Trên Stata, bạn mã hóa biến chuỗi bằng lệnh encode Ticker, gen(id) rồi khai báo cấu trúc bảng bằng lệnh xtset id Year. Nếu màn hình hiện “strongly balanced” hoặc “unbalanced, delta: 1 unit”, dữ liệu đã sẵn sàng để ước lượng.
Các khuyết tật thống kê trên dữ liệu bảng và giải pháp khắc phục
Sau khi chọn được mô hình phù hợp (FEM hoặc REM), nhà nghiên cứu cần kiểm tra 3 khuyết tật điển hình:
- Hiện tượng phương sai sai số thay đổi (Heteroscedasticity): Kiểm tra bằng lệnh xttest3 (Modified Wald test cho FEM).
- Hiện tượng tự tương quan chuỗi (Serial Correlation): Kiểm tra bằng kiểm định Wooldridge thông qua lệnh xtserial Y X1 X2.
- Hiện tượng phụ thuộc chéo giữa các thực thể (Cross-sectional Dependence): Kiểm tra bằng kiểm định Pesaran CD test.
- Giải pháp khắc phục toàn diện: Nếu mô hình vi phạm đồng thời phương sai thay đổi và tự tương quan, nhà nghiên cứu sử dụng Phương pháp Bình phương cực tiểu tổng quát khả thi FGLS (lệnh xtgls Y X1 X2, panels(heteroskedastic) corr(ar1)) hoặc ước lượng với Sai số chuẩn hiệu chỉnh Driscoll-Kraay (lệnh xtscc) để thu được các hệ số ước lượng vững và chuẩn xác.
Câu hỏi thường gặp về dữ liệu bảng là gì (FAQ)
Tại sao không nên sắp xếp dữ liệu theo dạng ngang (Wide Format – mỗi năm một cột) khi chạy Stata?
Dạng ngang khiến phần mềm hiểu nhầm mỗi năm là một biến số riêng biệt độc lập; Stata bắt buộc dữ liệu phải xếp dạng dọc (Long Format) để ghép cặp chỉ số không gian i và thời gian t. Bạn có thể chuyển từ dạng ngang sang dọc bằng lệnh reshape long.
Quy mô mẫu dữ liệu bảng bao nhiêu là đủ cho một luận văn thạc sĩ tài chính?
Một bộ dữ liệu bảng tiêu chuẩn thường bao gồm tối thiểu từ 50 đến 150 doanh nghiệp được thu thập liên tục trong khoảng thời gian từ 5 đến 10 năm (tạo ra từ 300 đến 1.500 quan sát).
Mô hình FEM có ước lượng được các biến không thay đổi theo thời gian (như Ngành nghề, Vị trí địa lý) không?
Không; phép biến đổi khử hiệu ứng cố định trong FEM sẽ triệt tiêu toàn bộ các biến không thay đổi theo thời gian (Time-invariant variables); nếu cần đánh giá các biến này, bạn phải sử dụng mô hình REM hoặc kỹ thuật Hausman-Taylor.
Kết luận và định hướng ứng dụng
Hiểu tường tận Dữ liệu bảng là gì mở ra cánh cửa giúp người làm nghiên cứu làm chủ các kỹ thuật phân tích định lượng hiện đại, nâng cao độ tin cậy của các phát hiện thực nghiệm trong lĩnh vực kinh tế và tài chính. Để tải về bộ dữ liệu bảng mẫu của các công ty niêm yết trên sàn HOSE/HNX và tệp lệnh Do-file Stata hoàn chỉnh, mời quý bạn đọc tham khảo tại Nguyễn Thanh Phương.
Giảng viên Nguyễn Thanh Phương là chuyên gia chuyên sâu về Nghiên cứu khoa học, Ứng dụng AI, Digital Marketing và Quản trị bản thân. Với kinh nghiệm giảng dạy thực chiến, tác giả trực tiếp hướng dẫn ứng dụng phương pháp luận và phân tích dữ liệu chuyên sâu cho người học nên được sinh viên gọi là Thầy giáo quốc dân. Mọi nội dung chia sẻ đều tuân thủ nguyên tắc khách quan, thực chứng và mang giá trị ứng dụng cao, hướng tới mục tiêu cốt lõi: “Làm bạn tốt hơn!