Categorical data là gì (Dữ liệu phân loại hay Dữ liệu định tính – Qualitative Data) là dạng dữ liệu thống kê dùng để phân chia các quan sát vào các nhóm, hạng mục hoặc nhãn thuộc tính riêng biệt dựa trên đặc điểm phẩm chất thay vì đo lường bằng đơn vị số học liên tục. Trong nghiên cứu khoa học xã hội, quản trị nhân sự, y học và học máy (Machine Learning), các biến số như Giới tính, Trình độ học vấn, Ngành nghề kinh doanh, Khu vực địa lý hay Mức độ hài lòng đều là dữ liệu phân loại; việc nhận diện đúng cấp độ của chúng là yếu tố tiên quyết để lựa chọn phép kiểm định thống kê và kỹ thuật mã hóa biến giả (Dummy Coding) chuẩn xác.
Bản chất và đặc trưng nhận diện của Categorical Data
Khác với dữ liệu định lượng (Numerical Data) trả lời cho câu hỏi “Bao nhiêu?”, Categorical data là gì trả lời cho câu hỏi “Thuộc loại nào, nhóm nào?” với 3 đặc tính nền tảng:
- Tính loại trừ lẫn nhau (Mutually Exclusive) và Toàn diện (Exhaustive): Mỗi quan sát trong mẫu khảo sát chỉ được xếp vào một hạng mục phân loại xác định (ví dụ: trạng thái doanh nghiệp là Đang hoạt động hoặc Đã giải thể).
- Con số chỉ mang ý nghĩa ký hiệu định danh: Trong phần mềm SPSS hay Stata, người nghiên cứu thường gán các con số như 1 = Hà Nội, 2 = Đà Nẵng, 3 = TP.HCM. Tuy nhiên, các con số này thuần túy là mã số gán nhãn; bạn không thể thực hiện phép cộng 1 + 2 = 3 (Hà Nội cộng Đà Nẵng không thể bằng TP.HCM) và việc tính giá trị trung bình cộng (Mean) cho biến này là vô nghĩa về mặt toán học.
- Được tổng hợp qua Tần số (Frequency) và Tỷ lệ phần trăm (Percentage): Thống kê mô tả chuẩn mực dành cho dữ liệu phân loại là đếm số lượng quan sát rơi vào từng nhóm (f_i), tính tỷ lệ phần trăm (%) và xác định Yếu vị (Mode – nhóm có tần số xuất hiện nhiều).
“Trong thế giới của Categorical Data, các con số đã cởi bỏ chiếc áo giá trị đại số để khoác lên mình tấm thẻ tên định danh cho từng nhóm đối tượng nghiên cứu.”
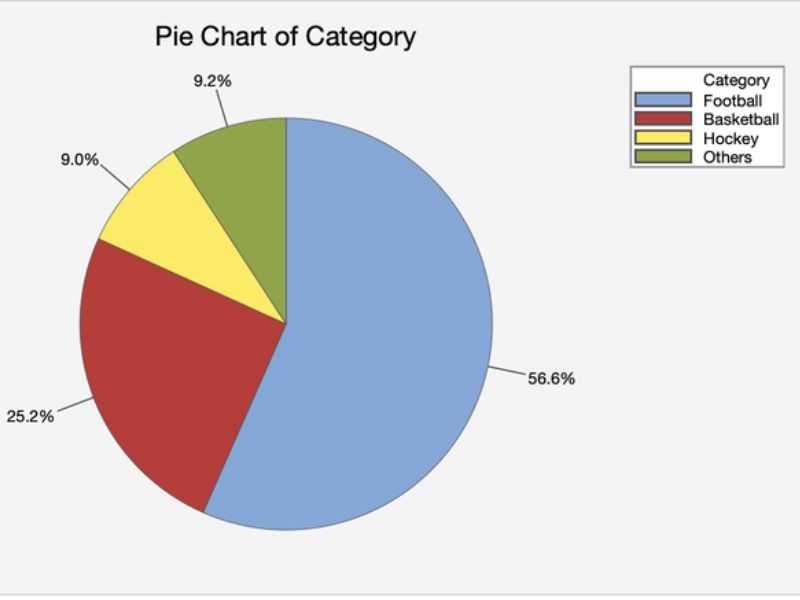
2 cấp độ thang đo của Categorical Data: Định danh (Nominal) và Thứ bậc (Ordinal)
Theo hệ thống phân loại thang đo của Stanley Smith Stevens (1946), dữ liệu phân loại được chia thành hai cấp độ có tính chất thông tin khác biệt rõ rệt:
1. Dữ liệu định danh / Danh nghĩa (Nominal Data)
Là cấp độ phân loại cơ bản, trong đó các hạng mục hoàn toàn ngang hàng nhau và không có bất kỳ trật tự hơn kém, cao thấp nào:
- Ví dụ điển hình: Giới tính (Nam, Nữ), Tình trạng hôn nhân (Độc thân, Đã kết hôn), Nhóm máu (A, B, AB, O), Ngành nghề niêm yết (Bất động sản, Ngân hàng, Công nghệ, Bán lẻ), Phương thức thanh toán (Tiền mặt, Chuyển khoản, Ví điện tử).
- Trường hợp đặc biệt – Dữ liệu nhị phân (Binary / Dichotomous Data): Là biến định danh chỉ có đúng 2 trạng thái đối lập nhau (0 và 1: Có/Không, Đậu/Trượt, Xuất khẩu/Nội địa).
2. Dữ liệu thứ bậc / Thứ tự (Ordinal Data)
Là dữ liệu phân loại mà giữa các hạng mục có tồn tại trật tự sắp xếp từ thấp đến cao hoặc từ kém đến tốt, nhưng khoảng cách chênh lệch giữa các bậc không đều nhau hoặc không đo lường được bằng đơn vị chuẩn:
- Ví dụ điển hình: Trình độ học vấn (Trung học → Cao đẳng → Đại học → Thạc sĩ → Tiến sĩ); Xếp hạng tín nhiệm trái phiếu (AAA, AA, A, BBB, BB); Mức thu nhập phân tổ (Dưới 10 triệu → 10 – 20 triệu → Trên 20 triệu); và các câu hỏi đơn lẻ trên Thang đo Likert 5 mức độ (1: Hoàn toàn phản đối → 5: Hoàn toàn đồng ý).
- Đại lượng thống kê đại diện: Ngoài tần số và Mode, dữ liệu thứ bậc cho phép tính toán thêm Số trung vị (Median) và các phân vị (Quartiles) nhờ có tính thứ tự.
Bảng so sánh đối chuẩn giữa Dữ liệu Định danh, Thứ bậc và Định lượng
Dưới đây là bảng ma trận phân biệt các cấp độ dữ liệu và công cụ thống kê tương ứng:
| Tiêu chí phân biệt | Dữ liệu Định danh (Nominal) | Dữ liệu Thứ bậc (Ordinal) | Dữ liệu Định lượng (Scale) |
|---|---|---|---|
| Bản chất thông tin | Phân nhóm khác biệt, không thứ tự | Phân nhóm có thứ tự cao thấp | Đo lường độ lớn bằng con số thực |
| Phép toán hợp lệ | Đếm tần số (=, ≠) | So sánh thứ tự (>, <) | Cộng, trừ, nhân, chia (+, -, ×, ÷) |
| Thước đo trung tâm | Yếu vị (Mode) | Trung vị (Median) và Mode | Trung bình cộng (Mean), Median, Mode |
| Biểu đồ trực quan | Biểu đồ tròn (Pie), Cột rời (Bar) | Biểu đồ cột xếp thứ tự (Ordered Bar) | Histogram, Boxplot, Scatter Plot |
| Kiểm định mối liên hệ | Chi-Square, Fisher’s Exact, Cramer’s V | Tương quan hạng Spearman, Kendall | Tương quan Pearson, Hồi quy OLS |
| Kiểm định khác biệt nhóm | McNemar (ghép cặp), Cochran’s Q | Mann-Whitney U, Kruskal-Wallis | Independent t-test, One-way ANOVA |
Kỹ thuật đưa Categorical Data vào mô hình hồi quy: Mã hóa biến giả (Dummy Coding / One-Hot Encoding)
Một câu hỏi thực hành rất quan trọng trong luận văn và học máy là: Làm thế nào để đưa một biến phân loại có nhiều nhóm (ví dụ: Khu vực gồm Bắc, Trung, Nam) vào làm biến độc lập trong phương trình hồi quy tuyến tính OLS hoặc SEM?
- Sai lầm nghiêm trọng cần tránh: Đưa trực tiếp biến mã hóa 1 = Miền Bắc, 2 = Miền Trung, 3 = Miền Nam vào phương trình OLS. Khi đó máy tính sẽ hiểu lầm rằng Miền Nam “lớn gấp 3 lần” Miền Bắc về mặt định lượng, làm cho hệ số hồi quy hoàn toàn sai lệch.
- Quy tắc k – 1 biến giả (Dummy Variable Rule): Nếu một biến phân loại định danh có k nhóm, bạn bắt buộc phải chọn ra 1 nhóm làm Nhóm cơ sở đối chiếu (Reference / Baseline Category) và tạo ra (k – 1) biến giả nhị phân (chỉ nhận giá trị 0 hoặc 1).
- Ví dụ minh họa với biến Khu vực (k = 3 nhóm): Chọn Miền Bắc làm nhóm cơ sở đối chiếu. Ta tạo ra 2 biến giả:
- Biến giả D_Trung = 1 nếu khách hàng ở Miền Trung, = 0 nếu ở khu vực khác.
- Biến giả D_Nam = 1 nếu khách hàng ở Miền Nam, = 0 nếu ở khu vực khác.
- Phương trình hồi quy: ChiTiêu = β₀ + β₁×ThuNhập + γ₁×D_Trung + γ₂×D_Nam + ε. Khi đó, hệ số γ₂ đo lường mức chênh lệch chi tiêu trung bình của khách hàng Miền Nam so với nhóm cơ sở Miền Bắc (khi có cùng mức thu nhập). Tại sao không tạo đủ cả 3 biến giả cho 3 miền? Vì nếu đưa cả 3 biến giả vào mô hình có hệ số chặn β₀, tổng của 3 biến giả luôn bằng 1 (D_Bac + D_Trung + D_Nam = 1), gây ra hiện tượng Đa cộng tuyến hoàn hảo (Bẫy biến giả – Dummy Variable Trap) khiến ma trận không thể nghịch đảo.
Hướng dẫn thao tác xử lý Categorical Data trên Stata, SPSS và Python
- Trên Stata: Dùng tiền tố i. trước biến phân loại (ví dụ: reg ChiTieu ThuNhap i.KhuVuc hoặc ib2.KhuVuc để chọn nhóm 2 làm cơ sở). Stata tự động tách k – 1 biến giả chuẩn xác.
- Trên IBM SPSS: Trong tab Variable View, cột Measure, chọn Nominal hoặc Ordinal. Dùng kiểm định Independent-Samples t-test (2 nhóm) hoặc One-Way ANOVA (từ 3 nhóm trở lên) để so sánh trung bình.
- Trong Python (Pandas): Dùng hàm pd.get_dummies(df, columns=[‘KhuVuc’], drop_first=True) để mã hóa k – 1 cột tránh bẫy biến giả cho biến Nominal, và dùng OrdinalEncoder cho biến Ordinal.
Câu hỏi thường gặp về Categorical data là gì (FAQ)
Biến số Số điện thoại, Mã số thuế hay Số căn cước công dân là dữ liệu định lượng hay Categorical Data?
Dù được viết hoàn toàn bằng các chữ số, Số điện thoại, Mã số thuế và Số căn cước công dân hoàn toàn là Categorical Data (Dữ liệu định danh – Nominal) vì các con số đó chỉ dùng để định danh cá nhân chứ không đo lường đại lượng nào.
Khi nào nên chọn nhóm nào làm nhóm cơ sở (Reference group) khi tạo biến giả?
Về mặt toán học, chọn nhóm nào làm nhóm cơ sở cũng cho ra độ phù hợp R² giống hệt nhau; tuy nhiên về mặt kinh tế học, bạn nên chọn nhóm có quy mô mẫu lớn hoặc nhóm mang tính tiêu chuẩn (như nhóm Đối chứng, nhóm Đa số) làm nhóm cơ sở để việc diễn giải so sánh trở nên trực quan.
Nếu kiểm định Chi-Square giữa hai biến Categorical Data có hơn 20% số ô có tần số kỳ vọng nhỏ hơn 5 thì xử lý thế nào?
Khi bảng chéo có nhiều ô có tần số kỳ vọng nhỏ hơn 5 (do cỡ mẫu nhỏ), xấp xỉ Chi-Square sẽ không còn chính xác; bạn chuyển sang đọc dòng kết quả Fisher’s Exact Test (Kiểm định chính xác của Fisher) ngay bên dưới bảng Output của SPSS hoặc dùng tùy chọn tab bien1 bien2, exact trên Stata.
Kết luận và định hướng ứng dụng
Hiểu rõ bản chất Categorical data là gì giúp nhà nghiên cứu thiết kế bảng hỏi khảo sát khoa học, lựa chọn đúng các phép kiểm định phi tham số và thực hiện kỹ thuật mã hóa biến giả chuẩn mực trong các mô hình hồi quy kinh tế lượng. Để tải về bộ tài liệu hướng dẫn kiểm định Chi-Square, ANOVA và tạo biến giả tự động trên SPSS/Stata, mời quý bạn đọc tham khảo tại nguyenthanhphuong.com.
Giảng viên Nguyễn Thanh Phương là chuyên gia chuyên sâu về Nghiên cứu khoa học, Ứng dụng AI, Digital Marketing và Quản trị bản thân. Với kinh nghiệm giảng dạy thực chiến, tác giả trực tiếp hướng dẫn ứng dụng phương pháp luận và phân tích dữ liệu chuyên sâu cho người học nên được sinh viên gọi là Thầy giáo quốc dân. Mọi nội dung chia sẻ đều tuân thủ nguyên tắc khách quan, thực chứng và mang giá trị ứng dụng cao, hướng tới mục tiêu cốt lõi: “Làm bạn tốt hơn!