Standard deviation STDEV là gì (Độ lệch chuẩn – thường viết tắt là SD, Std. Dev. trên SPSS/Stata hoặc hàm STDEV trên Excel) là một chỉ số thống kê mô tả đo lường khoảng cách chênh lệch trung bình của các giá trị quan sát cá thể trong tập dữ liệu so với giá trị trung bình cộng (Mean) của tập dữ liệu đó, được tính bằng căn bậc hai của phương sai (Variance). Nhờ có cùng đơn vị đo lường với dữ liệu gốc ban đầu, độ lệch chuẩn là thước đo độ phân tán và mức độ biến động trực quan, được sử dụng rộng rãi trong kiểm soát chất lượng sản xuất, phân tích khảo sát Likert và đo lường rủi ro tài chính.
Bản chất toán học và ưu thế đơn vị đo của Độ lệch chuẩn (SD / STDEV)
Khi tìm hiểu Standard deviation STDEV là gì, câu hỏi ban đầu là tại sao đã có Phương sai (Variance – s²) mà các nhà thống kê lại phải tính thêm Độ lệch chuẩn (Standard Deviation – s)?
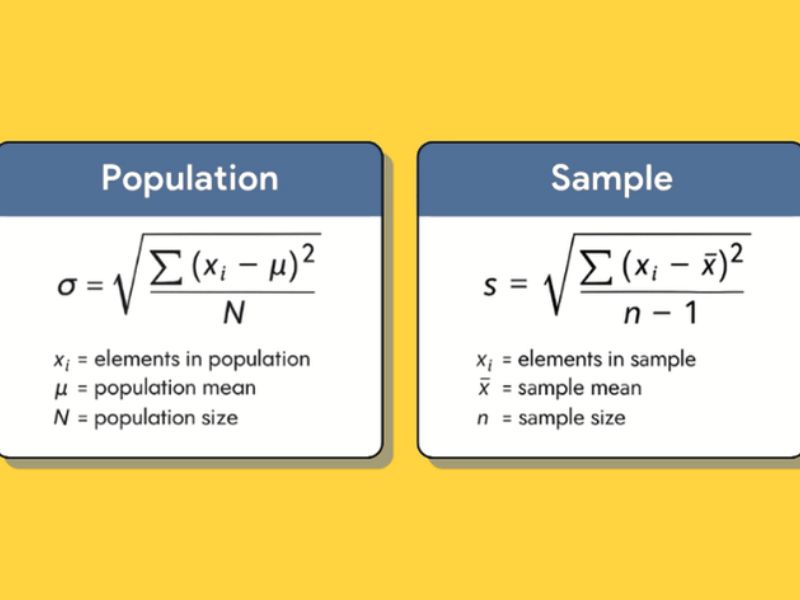
- Trong công thức tính phương sai s² = Σ(x_i – x̄)² / (n – 1), các độ lệch được bình phương lên để khử dấu âm, dẫn đến việc đơn vị đo bị biến dạng thành bình phương (ví dụ: tuổi² hay triệu đồng²).
- Bằng cách lấy căn bậc hai số học của phương sai, độ lệch chuẩn khôi phục lại hoàn toàn đơn vị đo gốc của biến số:
Độ lệch chuẩn mẫu (Sample Standard Deviation – STDEV.S): s = √[ Σ (x_i – x̄)² / (n – 1) ]
Độ lệch chuẩn tổng thể (Population Standard Deviation – STDEV.P): σ = √[ Σ (x_i – μ)² / N ] - Ý nghĩa trực quan của độ lớn SD:
- SD nhỏ (tiệm cận về 0): Các điểm dữ liệu tụ hội rất sát xung quanh giá trị trung bình Mean. Trong khảo sát bảng hỏi, SD nhỏ cho thấy các đáp viên có quan điểm đồng thuận cao; trong đầu tư tài chính, SD nhỏ phản ánh tài sản có biến động thấp và an toàn.
- SD lớn: Các điểm dữ liệu trải rộng và phân hóa mạnh sang hai cực. Trong khảo sát, SD lớn cho thấy ý kiến của đám đông đang chia rẽ sâu sắc (nhiều người chấm 1 điểm và nhiều người chấm 5 điểm); trong tài chính, SD lớn cảnh báo cổ phiếu có rủi ro biến động giá rất cao.
“Nếu hai con sông cùng được thông báo có độ sâu trung bình (Mean) là 1.2 mét, con sông thứ một có độ lệch chuẩn SD = 0.1 mét sẽ an toàn tuyệt đối để lội qua; nhưng con sông thứ hai có SD = 1.5 mét lại ẩn chứa những hố nước sâu tới 4 mét vô cùng nguy hiểm.”
Quy tắc thực nghiệm 68 – 95 – 99.7 (Empirical Rule / Three-Sigma Rule)
Đối với các tập dữ liệu định lượng tuân theo hình chuông đối xứng của Phân phối chuẩn (Normal Distribution), sự kết hợp giữa số trung bình (Mean – μ) và độ lệch chuẩn (SD – σ) xác lập nên quy tắc phân bổ xác suất kinh điển:
- Khoảng 1 độ lệch chuẩn [Mean ± 1 SD]: Chứa xấp xỉ 68.27% tổng số quan sát của toàn bộ tập dữ liệu. Đây là vùng biến thiên thông thường của số đông đại trà.
- Khoảng 2 độ lệch chuẩn [Mean ± 2 SD] (chính xác là ±1.96 SD): Chứa xấp xỉ 95.45% (hoặc 95%) tổng số quan sát. Các điểm nằm ngoài khoảng ±2 SD bắt đầu được coi là những trường hợp hiếm gặp (tạo nền tảng cho mức ý nghĩa thống kê α = 5%).
- Khoảng 3 độ lệch chuẩn [Mean ± 3 SD]: Chứa tới 99.73% tổng số quan sát của tập dữ liệu. Bất kỳ quan sát nào rơi ra bên ngoài ranh giới Mean ± 3 SD (chỉ chiếm xác suất 0.27% hay 1/370) đều được các phần mềm thống kê đánh dấu là Giá trị ngoại lai dị biệt (Outliers). Trong quản trị chất lượng công nghiệp, nguyên lý này được mở rộng thành tiêu chuẩn Six Sigma (±6 SD) nhằm giảm tỷ lệ sản phẩm lỗi xuống chỉ còn 3.4 lỗi trên một triệu sản phẩm.
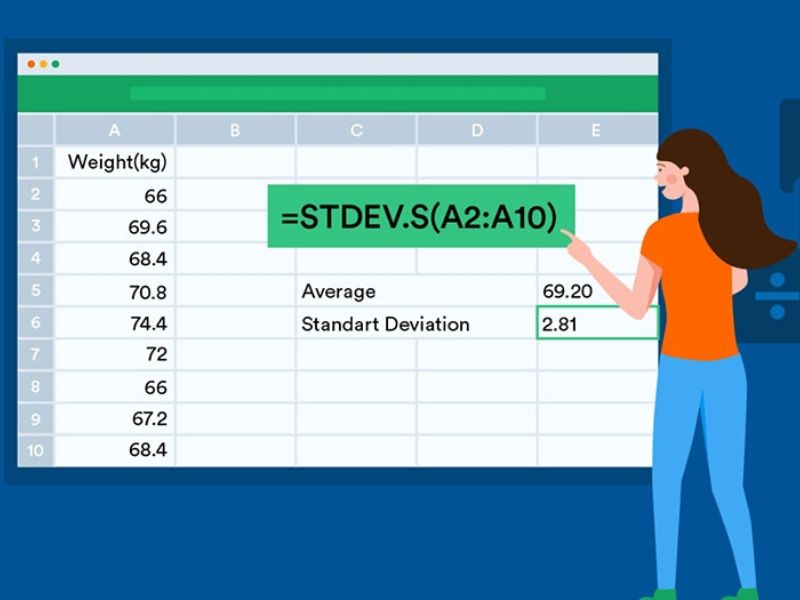
Bảng phân biệt các hàm tính độ lệch chuẩn STDEV trong Microsoft Excel
Trong Microsoft Excel, có tới 6 hàm khác nhau bắt đầu bằng chữ STDEV. Dưới đây là bảng đối chuẩn giúp bạn sử dụng đúng hàm cho từng trường hợp:
| Tên hàm trên Excel | Mẫu số chia trong công thức | Cách xử lý ô chứa chữ (Text) và Logic | Trường hợp khuyến nghị sử dụng |
|---|---|---|---|
| =STDEV.S(range) | Chia cho (n – 1) | Bỏ qua hoàn toàn các ô chữ và logic | Hàm chuẩn mực dùng cho mọi mẫu dữ liệu khảo sát, nghiên cứu |
| =STDEV.P(range) | Chia cho N | Bỏ qua hoàn toàn các ô chữ và logic | Chỉ dùng khi vùng dữ liệu là toàn bộ 100% tổng thể |
| =STDEV(range) | Chia cho (n – 1) | Bỏ qua các ô chữ và logic | Hàm phiên bản cũ (Excel 2007 trở về trước), tương đương STDEV.S |
| =STDEVA(range) | Chia cho (n – 1) | Quy đổi ô chữ và FALSE = 0; TRUE = 1 | Hạn chế dùng vì dễ làm sai lệch kết quả nếu có ô ghi chú chữ |
Ứng dụng Độ lệch chuẩn để tính Điểm chuẩn hóa Z-score và Hệ số biến thiên CV
Trong phân tích thống kê nâng cao, độ lệch chuẩn là mẫu số không thể thiếu để thiết lập hai chỉ số so sánh tương đối:
1. Điểm chuẩn hóa Z-score (Standardized Score)
Được tính bằng công thức: Z_i = (x_i – Mean) / SD. Chỉ số Z-score cho biết một quan sát cụ thể nằm cao hơn hay thấp hơn trung bình bao nhiêu lần độ lệch chuẩn, giúp quy đổi các biến số có đơn vị đo khác nhau (như Doanh thu tính bằng tỷ đồng và Số năm hoạt động tính bằng năm) về cùng một mặt bằng chuẩn hóa có trung bình bằng 0 và độ lệch chuẩn bằng 1.
2. Hệ số biến thiên (Coefficient of Variation – CV)
Khi muốn so sánh mức độ phân tán hoặc rủi ro giữa hai biến số có giá trị trung bình chênh lệch nhau quá lớn (ví dụ: biến động giá cổ phiếu A có thị giá 100.000đ và cổ phiếu B có thị giá 10.000đ), ta không thể so sánh trực tiếp SD tuyệt đối mà phải tính Hệ số biến thiên CV:
CV = (SD / Mean) × 100%
Hệ số CV là một tỷ lệ phần trăm phi đơn vị; biến số nào có hệ số CV lớn hơn chứng tỏ biến số đó có mức độ biến động tương đối mạnh hơn quanh giá trị trung bình của nó.
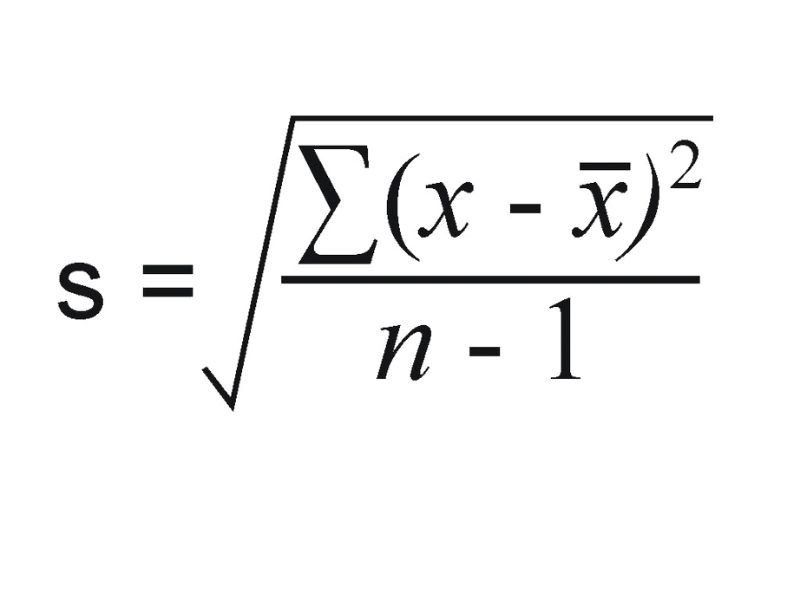
Cách đọc cột Std. Deviation trên phần mềm SPSS và Stata cho luận văn
Khi trình bày bảng thống kê mô tả trong luận văn thạc sĩ hoặc bài báo khoa học:
- Đối với thang đo Likert 5 mức độ (từ 1 đến 5): Giá trị Std. Deviation trên SPSS thông thường dao động trong khoảng từ 0.60 đến 1.15.
- Nếu một biến quan sát có Std. Deviation = 0.000: Có nghĩa là toàn bộ 100% người khảo sát đều chọn cùng một mức điểm giống hệt nhau (biến hằng số không có phương sai); biến này sẽ bị phần mềm tự động loại bỏ khi chạy Cronbach’s Alpha và EFA.
- Nếu các đáp viên trả lời lười biếng bằng cách đánh dấu cùng một mức điểm (ví dụ toàn bộ đều chọn mức 4 cho cả 30 câu hỏi – hiện tượng Straight-lining), bạn dùng hàm =STDEV.S(B2:AE2) theo từng hàng ngang của từng đáp viên trên Excel: bất kỳ dòng phiếu nào có STDEV.S < 0.25 là phiếu khảo sát ảo không trung thực và cần được lọc bỏ ngay ở bước làm sạch dữ liệu.
Câu hỏi thường gặp về Standard deviation STDEV là gì (FAQ)
Độ lệch chuẩn (Standard Deviation) có bao giờ nhận giá trị âm không?
Không bao giờ; vì độ lệch chuẩn là căn bậc hai số học của tổng các bình phương nên giá trị của nó luôn luôn lớn hơn hoặc bằng 0 (SD ≥ 0).
Tại sao kết quả tính độ lệch chuẩn bằng máy tính cầm tay Casio đôi khi lệch một chút so với hàm STDEV.P trên Excel?
Do trên máy tính Casio có hai ký hiệu: σ_x (chia cho N – khớp với STDEV.P) và s_x (chia cho n – 1 – khớp với STDEV.S và khớp với kết quả của SPSS/Stata); trong nghiên cứu khoa học bạn luôn chọn ký hiệu s_x (hoặc STDEV.S).
Khi dữ liệu bị lệch nặng và có nhiều Outliers thì Độ lệch chuẩn SD có còn đáng tin cậy không?
Khi dữ liệu bị lệch nặng bởi các điểm ngoại lai cực đoan, cả Mean và SD đều bị phóng đại sai lệch; lúc đó bạn nên báo cáo Số trung vị (Median) đi kèm với Khoảng tứ phân vị (Interquartile Range: IQR = Q3 – Q1) thay cho cặp Mean và SD.
Kết luận và định hướng thực hành
Nắm vững bản chất Standard deviation STDEV là gì giúp nhà nghiên cứu không chỉ mô tả chuẩn xác độ biến thiên của dữ liệu mà còn ứng dụng thành thạo kỹ thuật lọc phiếu khảo sát kém chất lượng (Straight-lining) và phát hiện điểm ngoại lai theo quy tắc 3-Sigma. Để tải về file Excel mẫu lọc phiếu khảo sát tự động bằng hàm STDEV.S và hướng dẫn đọc kết quả SPSS, mời quý bạn đọc tham khảo tại Th.S Nguyễn Thanh Phương.
Giảng viên Nguyễn Thanh Phương là chuyên gia chuyên sâu về Nghiên cứu khoa học, Ứng dụng AI, Digital Marketing và Quản trị bản thân. Với kinh nghiệm giảng dạy thực chiến, tác giả trực tiếp hướng dẫn ứng dụng phương pháp luận và phân tích dữ liệu chuyên sâu cho người học nên được sinh viên gọi là Thầy giáo quốc dân. Mọi nội dung chia sẻ đều tuân thủ nguyên tắc khách quan, thực chứng và mang giá trị ứng dụng cao, hướng tới mục tiêu cốt lõi: “Làm bạn tốt hơn!